Wyrażenie „uruchom własną dziewczynę AI” brzmi, jakby chodziło o jeden program. W praktyce to trzy elementy, które ze sobą rozmawiają, a zrozumienie, co robi który, oszczędza większość frustracji.
Trzy elementy
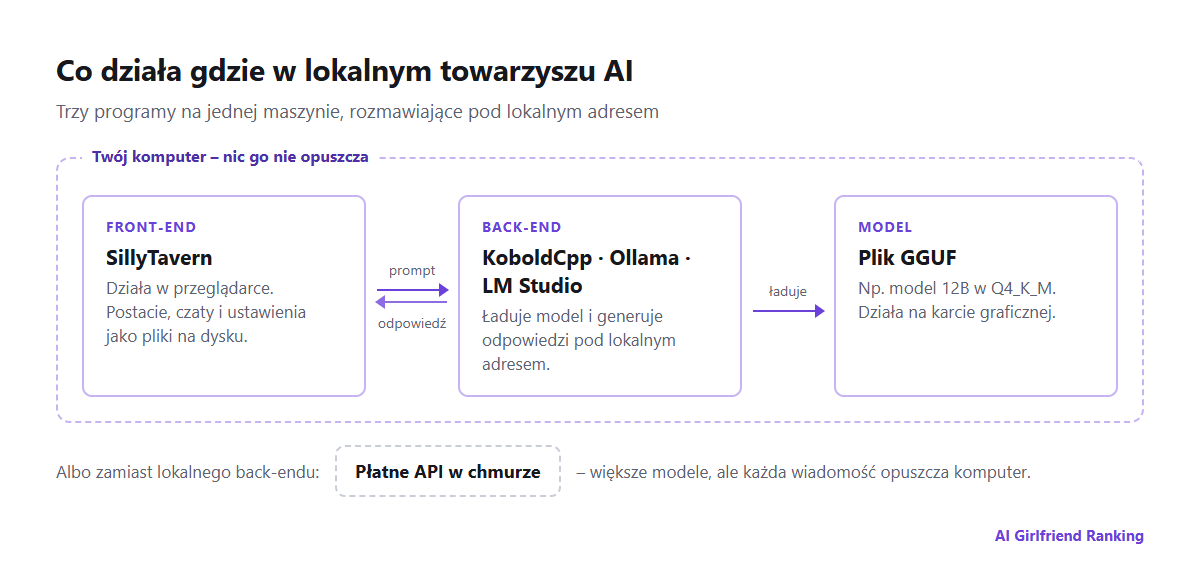
Co z czym rozmawia w typowej konfiguracji lokalnej.
Front-end to to, co widzisz: okna czatu, postacie, awatary, ustawienia. SillyTavern to standardowy wybór do czatu z postaciami. Działa w przeglądarce, przechowuje postacie i czaty jako pliki na twoim dysku i łączy się z prawie każdym back-endem. Sam nie generuje tekstu.
Back-end ładuje model i generuje odpowiedzi. KoboldCpp to pojedynczy program bez instalacji, popularny do odgrywania ról, bo udostępnia każde ustawienie generowania. Ollama to najłatwiejszy sposób uruchomienia modelu kilkoma poleceniami. LM Studio to aplikacja desktopowa z przyjazną przeglądarką modeli. Każdy z nich udostępnia model pod lokalnym adresem, z którym łączy się front-end.
Model to duży plik, zwykle w formacie GGUF, pobierany z Hugging Face. Jego rozmiar w parametrach – 8B, 12B, 24B – i kwantyzacja decydują o tym, jak jest dobry i jakiego sprzętu wymaga.
Pytanie o sprzęt
O tym, czy model działa dobrze, decyduje pamięć karty graficznej (VRAM). Model musi się zmieścić, plus miejsce na samą rozmowę. Kwantyzacja zmniejsza modele, by się zmieściły: „Q4_K_M” to popularny kompromis między rozmiarem a jakością.
| Rozmiar modelu | Przybliżona pamięć przy Q4 | Typowy sprzęt | Czego się spodziewać |
|---|---|---|---|
| 7–8B | 5–6 GB | Karta graficzna 8 GB | Spójny, szybki, zapomina szczegóły w długich scenach |
| 12–14B | 9–10 GB | Karta 12 GB | Wyraźnie lepsze postacie i proza |
| 22–24B | 14–16 GB | Karta 16–24 GB | Blisko dobrych hostowanych aplikacji do odgrywania ról |
| 70B | 40 GB+ | Dwie karty lub Mac z dużą pamięcią | Doskonały, wolny i drogi |
Te liczby są przybliżone: dłuższy kontekst wymaga dodatkowej pamięci. Maki z Apple Silicon dzielą pamięć między procesor a grafikę, więc MacBook z 32 GB może uruchamiać modele, których nie uruchomi karta 12 GB. Model, który się nie mieści, wylewa się na procesor główny i zwalnia do żółwiego tempa – jeśli odpowiedzi przychodzą w tempie kilku słów na sekundę, przejdź na mniejszy model, zanim spróbujesz ostrzejszej kwantyzacji. Mniejszy model w dobrej jakości zwykle bije większy, ściśnięty zbyt mocno.
Co zyskujesz
- Prywatność niezależną od polityki. Nic nie opuszcza maszyny. Bez okresu przechowywania, treningu, dostępu pracowników, niczego do usuwania później.
- Brak filtra poza własnym filtrem modelu. Sam wybierasz model, w tym te dostrojone właśnie do odgrywania ról. Prawna dolna granica treści nadal cię obowiązuje, ale żaden operator nie dokłada reguł od siebie.
- Bez subskrypcji i kredytów. Generuj tyle, ile chcesz.
- Postacie, które są twoje. Karty postaci to zwykłe obrazy PNG z osadzonym opisem postaci. Przenoszą się między front-endami i żadna aktualizacja ich nie zabierze.
- Stabilność. Model, który działa dziś, za pięć lat działa tak samo. Nikt nie może go podmienić pod tobą – to ryzyko opisane w tekście gdy towarzysz AI zmienia się z dnia na dzień.
Z czego rezygnujesz
- Czas konfiguracji. Licz na wieczór do pierwszego działającego czatu i tygodnie majsterkowania, jeśli to lubisz.
- Pamięć to twoja sprawa. Hostowane aplikacje po cichu streszczają i zapisują fakty o tobie. Lokalnie zarządzasz tym przez lorebooki, streszczenia i notatki postaci w SillyTavern – te same trzy mechanizmy wyjaśnione w tekście jak działa pamięć towarzysza AI, tylko z odsłoniętymi kontrolkami.
- Obrazy i głos to osobne projekty. Generowanie obrazów wymaga własnego modelu i zwykle więcej pamięci graficznej; głos wymaga narzędzi do rozpoznawania i syntezy mowy. Wszystko możliwe, nic automatyczne.
- Mobilnie jest niewygodnie. Możesz otworzyć front-end z telefonu w domowym Wi-Fi. Użycie poza domem oznacza wystawienie komputera do internetu, co wymaga ostrożności.
- Sufit jakości. Najlepsze hostowane modele są większe niż cokolwiek, co większość ludzi uruchomi w domu, zwłaszcza pod kątem długoterminowej spójności.
Droga środka i jej haczyk
Wiele osób uruchamia SillyTavern na własnej maszynie, ale łączy go z płatnym API w chmurze zamiast z modelem lokalnym. Dostajesz kontrolę front-endu i pliki postaci, znacznie większe modele i rozliczenie za wiadomość, które przy lekkim użyciu bywa tanie.
Nie jest to jednak prywatne. Każda wiadomość trafia do dostawcy API, pod jego logowanie, przechowywanie i zasady treści – często surowsze wobec odgrywania ról niż w wyspecjalizowanych aplikacjach z towarzyszem. To inny kompromis, nie konfiguracja lokalna.
Podstawy bezpieczeństwa
- Pobieraj oprogramowanie tylko z oficjalnych stron projektów na GitHubie lub ze strony samego projektu.
- Pobieraj modele od znanych użytkowników Hugging Face i preferuj pliki GGUF, które zawierają dane modelu, a nie kod.
- Przeczytaj licencję modelu. Niektóre ograniczają użycie komercyjne; kilka ogranicza pewne treści.
- Trzymaj SillyTavern związany z własną maszyną lub siecią domową, chyba że ustawiłeś hasło i rozumiesz, co wystawiasz.
SillyTavern powstaje otwarcie na GitHubie.
Dla kogo to jest
Uruchom towarzysza lokalnie, jeśli twoim głównym zmartwieniem jest prywatność, masz już wydajny sprzęt albo konfigurowanie sprawia ci tyle samo radości co używanie. Zostań przy hostowanej aplikacji, jeśli chcesz, by głos, obrazy i długa pamięć działały od razu, albo piszesz głównie na telefonie. Nasz poradnik wyboru pierwszej aplikacji opisuje tę drogę. Wielu ludzi kończy z obiema: hostowaną aplikacją dla wygody i konfiguracją lokalną dla rozmów, których wolą nigdzie indziej nie przechowywać.